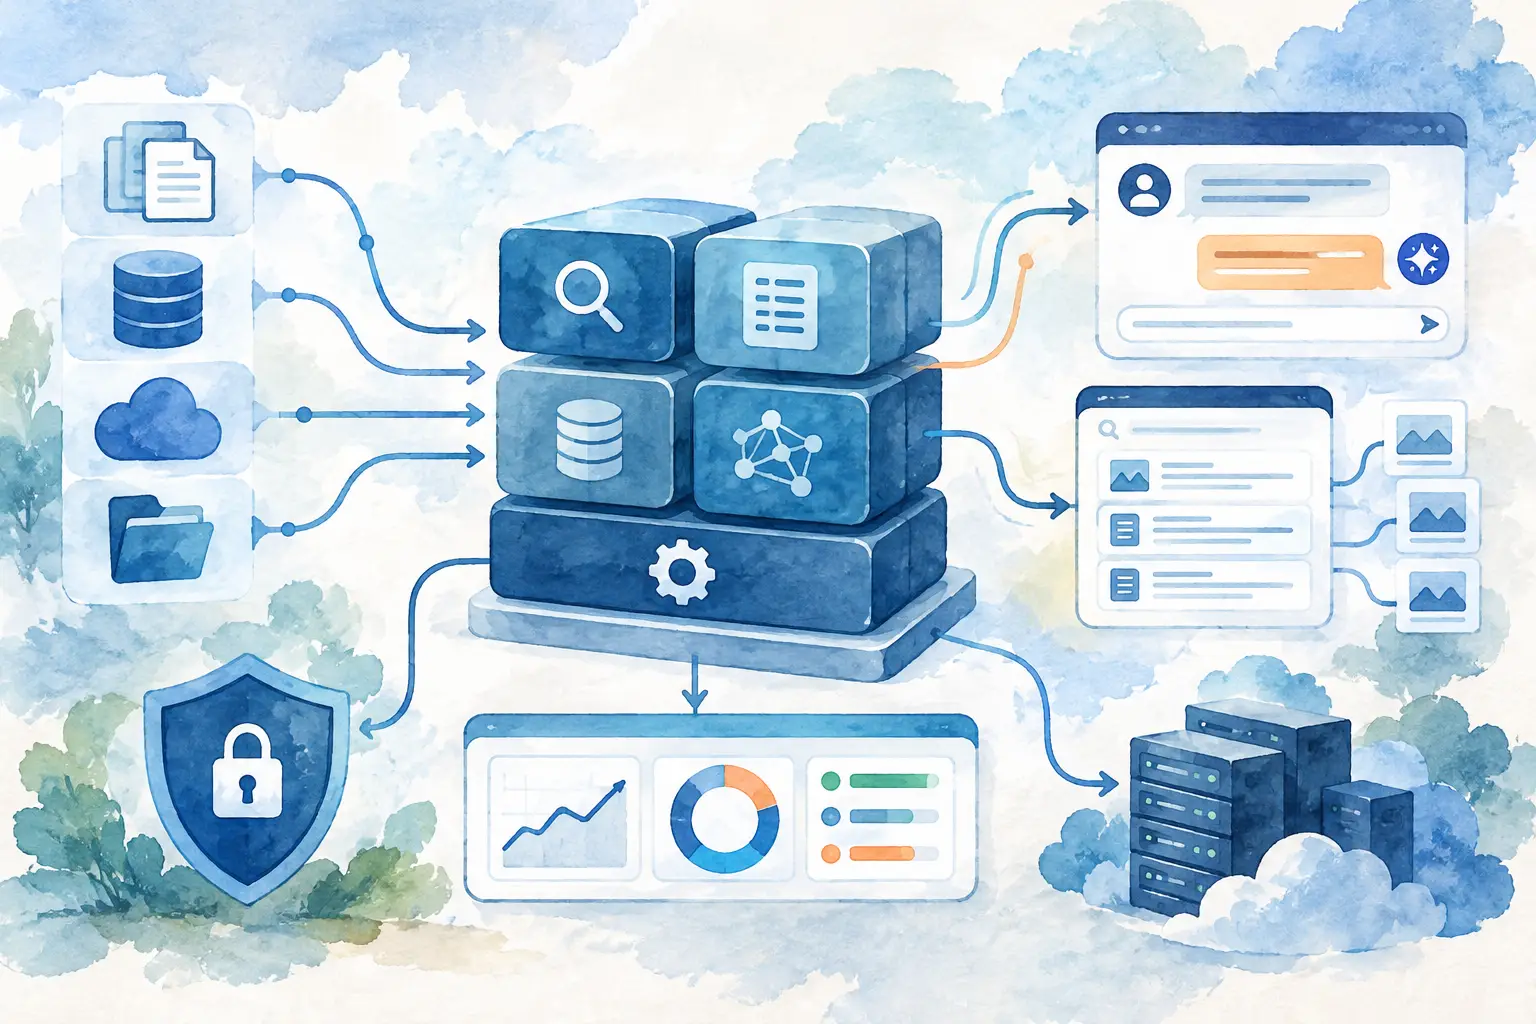
כשפיצ'ר RAG עונה תשובה שגויה, מציג מקור חסר, חושף מידע מחשבון אחר או פשוט מגיב לאט מדי, הבעיה אינה תמיד במודל השפה. לא פעם, שורש הבעיה הוא מבנה המערכת. ארכיטקטורה מודולרית מאפשרת לבודד את נקודת הכשל, לתקן אותה בלי לערער רכיבים תקינים, ולמדוד אם התיקון אכן שיפר את התוצאה עבור משתמשים אמיתיים.
במוצר SaaS שכבר רץ מול לקוחות, זו אינה העדפה תיאורטית של צוות הפיתוח. זו דרך לצמצם סיכון. אם תהליך האחזור, בדיקת ההרשאות, בניית ה-prompt והצגת הציטוטים מחוברים זה לזה באותו שירות ובאותו קוד, כל שינוי קטן עלול ליצור תקלה במקום אחר. התוצאה היא צוות שמפחד לגעת במערכת, או גרוע מכך - משחרר שינויים בלי לדעת מה נשבר.
מהי ארכיטקטורה מודולרית בהקשר של מוצר AI
ארכיטקטורה מודולרית מחלקת מערכת לרכיבים בעלי אחריות ברורה וממשקים מוגדרים ביניהם. אין הכוונה לפיצול מלאכותי לעשרות שירותים קטנים. המטרה היא שכל רכיב יטפל בבעיה אחת מהותית, ויוכל להשתנות בלי שהמערכת כולה תלויה בפרטי המימוש שלו.
בפיצ'ר RAG, למשל, אפשר להפריד בין שכבת קבלת הבקשה, אימות המשתמש והחשבון, אחזור המסמכים, דירוג התוצאות, הרכבת ההקשר למודל, יצירת התשובה, הציטוטים, והמדידה לאחר התשובה. לכל שכבה יש קלט ופלט ברורים. כך אפשר להחליף מנגנון חיפוש, להוסיף כלל הרשאות או לשנות ספק מודל, בלי לשכתב את כל זרימת השיחה.
ההפרדה הזאת חשובה במיוחד כאשר המוצר מחזיק מידע של כמה לקוחות. הרשאות אינן כלל שאפשר להוסיף בסוף התהליך. הן צריכות ללוות את הבקשה מההתחלה ועד למסמך שנבחר, לציטוט שמוצג וללוג שנשמר. כאשר סינון לפי tenant או לפי משתמש קיים רק ב-prompt, מדובר בהנחיה למודל ולא באכיפת אבטחה.
הבעיה האמיתית: תלות סמויה בין רכיבים
מערכות רבות מתחילות כזרימה קצרה: המשתמש שואל, המערכת מחפשת, שולחת הקשר למודל ומחזירה תשובה. זה עובד בהדגמה. לאחר מכן מתווספים סוגי מסמכים, לקוחות עם מודלי הרשאה שונים, שפות נוספות, ספקי מודלים, דרישת ציטוטים, מגבלות עלויות ומסכי ניהול. אם הכול נשאר באותה פונקציה או באותו endpoint, נוצרת תלות סמויה.
לדוגמה, שינוי ב-chunking - חלוקת מסמך ליחידות קטנות לצורך חיפוש - עשוי לפגוע באיכות הציטוטים. שינוי במנגנון cache יכול להחזיר תשובה מהירה יותר, אבל להתעלם משינוי בהרשאות. שדרוג מודל שפה עשוי לשפר ניסוח, אך לשנות את האופן שבו הוא מתייחס למקורות שסופקו לו. ללא גבולות ברורים, קשה לדעת היכן לבדוק ומה בדיוק השתנה.
המחיר אינו רק טכני. כשאין יכולת לבודד שינוי, אין יכולת לתכנן שחרור אחראי. צוותי מוצר מתחילים להימנע משיפורים נחוצים, וצוותי פיתוח משקיעים זמן בחקירת תקלות במקום בהתקדמות. מערכת אמינה אינה רק קוד שעובד כרגע, אלא מערכת שאפשר לשנות בביטחון סביר.
רכיבים שכדאי להפריד במערכת RAG
החלוקה המדויקת תלויה במוצר, אבל יש גבולות שחוזרים כמעט בכל מערכת חיה. שכבת הזהות וההרשאות צריכה להפיק הקשר מאומת של המשתמש, החשבון והתפקידים. היא לא אמורה להיות תלויה באופן שבו המסמכים נשמרים או במודל שנבחר ליצירת התשובה.
שכבת האחזור אחראית למצוא מועמדים רלוונטיים בלבד מתוך מידע שהמשתמש רשאי לראות. RAG הוא מנגנון שבו המערכת מאחזרת מידע חיצוני לפני שהיא מבקשת מהמודל לנסח תשובה. לכן איכות האחזור משפיעה ישירות על איכות התשובה, אך היא אינה אותו דבר כמו ניסוח התשובה. כדאי שתהיה אפשרות לבדוק את תוצאות החיפוש בפני עצמן: אילו מסמכים נמצאו, למה הם קיבלו דירוג מסוים, ואילו מסננים הופעלו.
שכבת ההרכבה בונה את ההקשר שנשלח למודל. כאן נקבעים אורך ההקשר, סדר המקורות, הוראות ההתנהגות והפורמט הנדרש לתשובה. השכבה הזאת צריכה להחזיר גם מזהים של המקורות שנשלחו, כדי ששכבת הציטוטים תוכל לקשור בין טענה לבין מקור אמיתי ולא להסתמך על טקסט שהמודל המציא.
לבסוף, שכבת מדידה מתעדת אירועים שימושיים: זמן תגובה, מספר מסמכים שאוחזרו, עלות משוערת, מקורות ששימשו בפועל, משוב משתמשים ותוצאת evals. Evals הם מקרי בדיקה קבועים שבודקים אם המערכת מחזירה תשובה מתאימה, מקורות נכונים ואפס חריגות הרשאה. בלי המדידה הזו, שינוי במערכת הוא בעיקר ניחוש.
ממשקים ברורים חשובים יותר מפיצול לשירותים
מודולריות לא מחייבת microservices. במערכות רבות, התחלה נכונה היא מודולים נפרדים בתוך אותו backend, עם חוזים ברורים ובדיקות מתאימות. זה פשוט יותר לתפעול, מהיר יותר לפיתוח, ולעיתים מספק את כל הגמישות הדרושה.
פיצול לשירותים נפרדים מתאים כאשר יש צורך אמיתי בפריסה עצמאית, סקייל שונה, בידוד אבטחתי או בעלות של צוותים שונים. אחרת, microservices עלולים להחליף תלות אחת בעשרות תלותיות חדשות: תורי הודעות, זמני רשת, גרסאות API ותקלות תצפיתיות. מודולריות היא קודם כל החלטה על גבולות אחריות, לא החלטה על מספר השרתים.
איך ארכיטקטורה מודולרית משפרת אמינות
כשמקור ציטוט חסר, אפשר לבדוק בנפרד אם המסמך אותר, אם הוא נכנס להקשר, אם מזהה המקור נשמר, או אם שכבת התצוגה לא הציגה אותו. כשמשתמש רואה מידע שלא היה אמור לראות, אפשר לעקוב אחר מסנן ההרשאות לאורך כל הזרימה במקום לחפש בקוד ענק שבו כל השלבים מעורבבים.
אותו עיקרון חל על ביצועים ועלויות. אפשר למדוד כמה זמן לוקח האחזור, כמה זמן לוקח המודל, ומה גודל ההקשר שנשלח בכל בקשה. לעיתים הפתרון לזמן תגובה איטי אינו החלפת מודל, אלא צמצום מסמכים לא רלוונטיים, שיפור index, או cache שמכבד את הקשר ההרשאות. כשכל רכיב מדיד, אפשר לקבל החלטה לפי נתונים ולא לפי תחושת בטן.
היתרון המשמעותי ביותר הוא יכולת השינוי. אפשר להריץ evals על רכיב אחזור חדש לפני שמחברים אותו לכל המשתמשים. אפשר לשחרר פורמט ציטוטים חדש מאחורי feature flag. אפשר להשוות ספקי מודלים כאשר שאר הזרימה קבועה. לא כל בדיקה חייבת להיות ניסוי גדול, אבל לכל שינוי צריך להיות גבול ברור ותנאי הצלחה ידועים.
סימנים שהמערכת שלכם זקוקה לחלוקה מחדש
אם כל תיקון ב-RAG מחייב שינוי באותו endpoint גדול, זה סימן ראשון. סימן נוסף הוא מצב שבו איש בצוות אינו יכול להסביר בוודאות איפה נאכפות הרשאות למסמכים, או האם הציטוטים מגיעים ממקורות שנשלחו למודל בפועל.
גם היעדר בדיקות איכות הוא אינדיקציה. אם השאלה היחידה לפני שחרור היא האם הצ'אט עדיין עונה, אין דרך לזהות הידרדרות בהחזרת מקורות, בעמידה בהרשאות או ברלוונטיות. במערכת עם לקוחות משלמים, תשובה שנשמעת משכנעת אך נשענת על מסמך שגוי היא תקלה, גם אם אין error בלוגים.
סימן שכיח נוסף הוא תלות חזקה בספק יחיד או במבנה נתונים יחיד. אין צורך להחליף ספקים תכופות, אבל כדאי שהלוגיקה העסקית לא תהיה משולבת בפרטי SDK מסוים. שכבת התאמה קטנה סביב ספק המודל או מנוע החיפוש יכולה למנוע עבודת שכתוב רחבה בעתיד.
דרך מעשית להתקדם בלי לעצור את הפיתוח
לא מומלץ לנסות לשרטט מחדש את כל המערכת בבת אחת. במוצר חי, שינוי הדרגתי הוא בדרך כלל בטוח יותר. מתחילים במיפוי זרימת בקשה אחת מקצה לקצה: מהזהות של המשתמש, דרך בחירת המסמכים ועד התשובה והציטוטים. המטרה היא לזהות היכן החלטות קריטיות מתקבלות כיום ללא תיעוד או ללא בדיקה.
לאחר מכן בוחרים גבול אחד בעל סיכון גבוה. ברוב המוצרים זה יהיה מנגנון ההרשאות או שכבת האחזור. מגדירים לו קלט ופלט, מוסיפים לוגים ומקרי evals, ואז מחליפים את המימוש מאחורי אותו ממשק. רק אחרי שהרכיב הזה יציב, ממשיכים לרכיב הבא.
חשוב להגדיר גם מה לא משנים. אם הבעיה היא דליפת מידע בין חשבונות, אין צורך באותו שלב להחליף מודל, לבנות מחדש את מסך הצ'אט ולשנות את כל מסד הנתונים. פוקוס מצמצם סיכון ומאפשר לדעת אם הפעולה פתרה את הבעיה.
מתי מודולריות הופכת לעומס
יש גם מחיר. לכל גבול חדש יש חוזה, בדיקות, תיעוד ולעיתים שכבת המרה. אם המערכת קטנה, יציבה ומבצעת פעולה אחת פשוטה, חלוקה מפורטת מדי תאט את הצוות בלי לייצר ערך. המבחן אינו אם המבנה נראה אלגנטי בתרשים, אלא אם הוא מאפשר להתמודד עם שינוי צפוי או סיכון ממשי.
במערכות SaaS עם AI, הסיכונים בדרך כלל כבר קיימים: שינויי ספקים, גדילה בכמות המסמכים, מודלי הרשאות מורכבים, דרישות audit וצורך לשפר איכות בלי לפגוע בתוצאות קיימות. לכן ארכיטקטורה מודולרית אינה מותרות, אבל גם לא תבנית קבועה. היא צריכה לשקף את המוצר, הצוות והכשלים שהמערכת עלולה לייצר בפועל.
אם פיצ'ר ה-AI שלכם חי אך קשה לשנות אותו בביטחון, התחילו בבדיקה קצרה של גבולות האחריות, ההרשאות והמדידה הקיימים. ב-DevCo Solutions אנחנו מבצעים ביקורת כזו במערכות קיימות ומגדירים תוכנית תיקון מעשית. אפשר לפנות דרך טופס יצירת הקשר באתר כדי לקבוע שיחת סקירה קצרה.