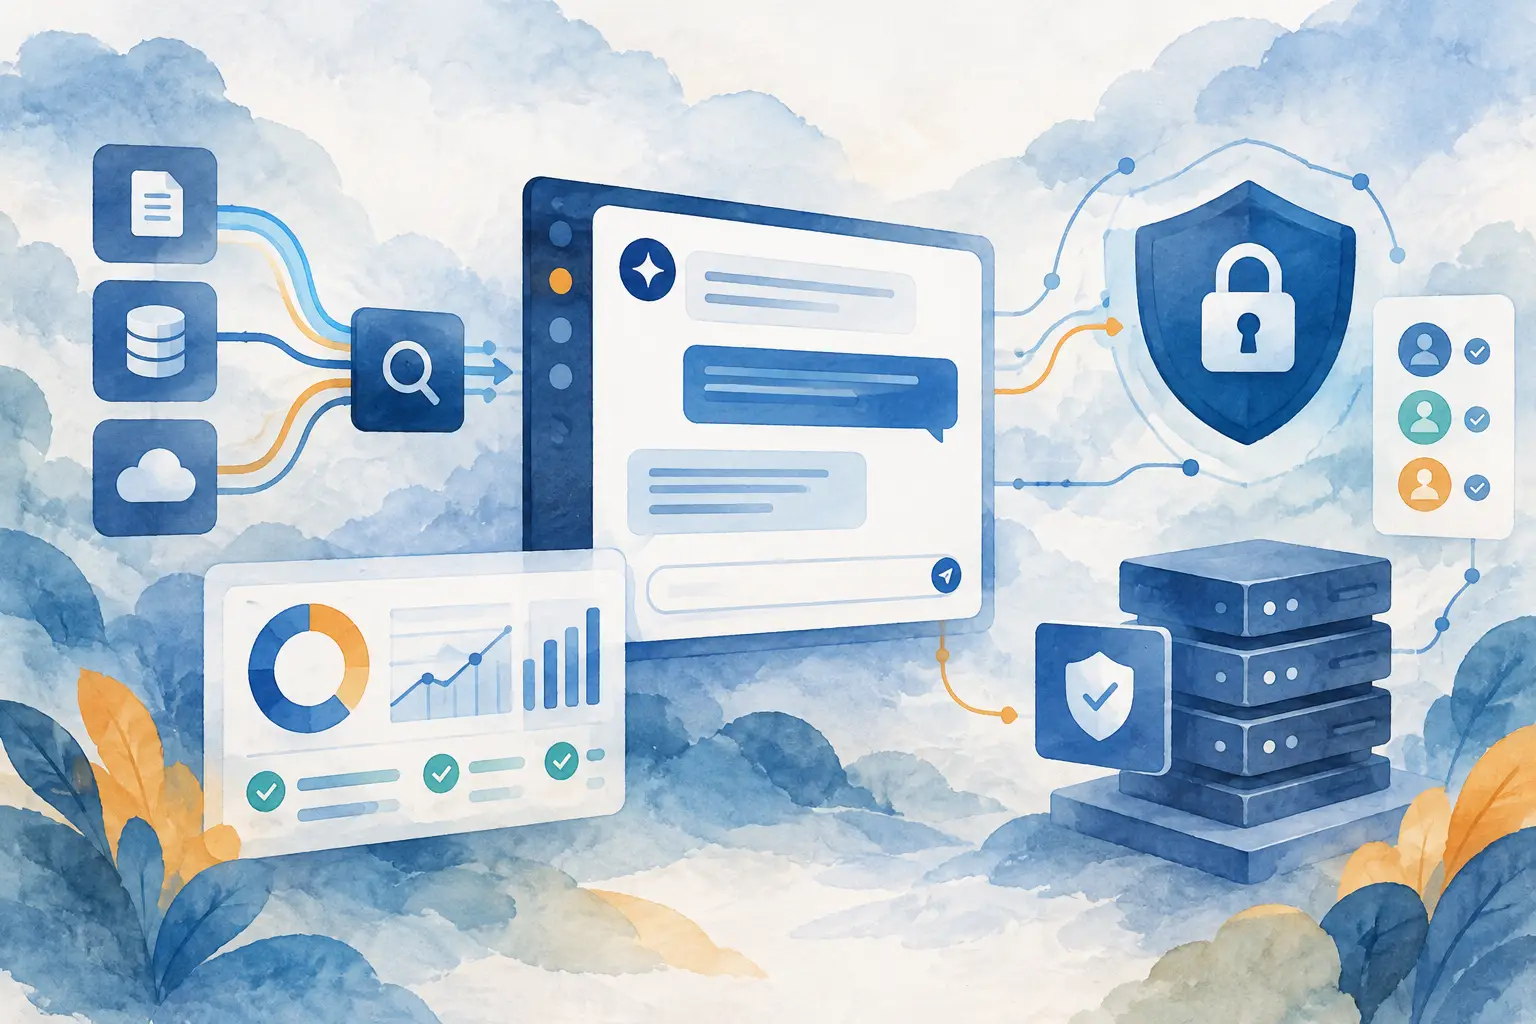
פיצ'ר AI יכול להיראות מצוין בהדגמה ולהפוך לסיכון מוצרי שבוע אחרי ההשקה. משתמש שואל שאלה פשוטה ומקבל תשובה שהומצאה, לקוח אחר אינו רואה את המקור שעליו התשובה מבוססת, ובמקרה החמור יותר - מידע מחשבון אחד מופיע למשתמש מחשבון אחר. אסטרטגיית מוצר דיגיטלי למערכת כזו אינה מסמך חזון כללי. היא ההחלטה המעשית מה המערכת רשאית לומר, על איזה מידע, למי, ובאיזו רמת ודאות אפשר לשחרר שינוי לפרודקשן.
במוצרי SaaS, הבעיה לרוב אינה בחירת מודל השפה. מודל טוב לא יתקן הרשאות שגויות, מסמכים שלא חולקו נכון, Retrieval לא מדויק או היעדר בדיקות איכות. Retrieval הוא שלב האחזור שבו המערכת מחפשת מידע רלוונטי לפני שהיא מנסחת תשובה. אם המידע שנשלף שגוי, חלקי או שייך לחשבון הלא נכון, התשובה הסופית תהיה בעייתית גם אם הניסוח שלה משכנע.
אסטרטגיית מוצר דיגיטלי מתחילה בגבולות ברורים
לפני שמרחיבים יכולות, צריך להגדיר את העבודה שהפיצ'ר אמור לבצע. לא מספיק לכתוב שהמערכת תענה על שאלות של משתמשים. ההגדרה צריכה לכלול אילו שאלות היא אמורה לפתור, אילו מקורות נחשבים סמכותיים, ומה עליה לעשות כאשר אין לה תשובה מבוססת.
לדוגמה, אם המוצר מאפשר למשתמשים להבין נתונים מתוך מסמכים פנימיים, התוצאה הרצויה אינה רק תשובה בשפה טבעית. התוצאה היא תשובה שניתן לבדוק: המשתמש צריך לדעת מאיזה מסמך, סעיף או רשומה היא נגזרה. אם אין מקור מתאים, התשובה הנכונה לעיתים היא לומר שאין מספיק מידע, ולא להשלים את החסר בניחוש.
זו החלטה מוצרית, לא רק החלטת פיתוח. היא משפיעה על אמון המשתמשים, על עלויות תמיכה ועל השאלה אם צוות המוצר יכול להרחיב את הפיצ'ר בבטחה. מערכת שמסרבת בצורה נכונה היא לעיתים מוצר טוב יותר ממערכת שעונה מהר על כל שאלה.
הגדירו הצלחה לפי משימה, לא לפי תחושה
מדד כמו מספר השיחות או מספר ההודעות אינו אומר אם הפיצ'ר מועיל. משתמשים יכולים לנהל שיחה ארוכה דווקא מפני שלא קיבלו תשובה ברורה. במקום זאת, כדאי לבחור משימות מרכזיות ולמדוד אותן באופן ישיר: האם נמצאו מקורות נכונים, האם הציטוט תואם לטענה, האם התשובה פעלה לפי הרשאות המשתמש, והאם זמן ההמתנה מתאים לחוויית המוצר.
אין מדד יחיד שמתאים לכל מערכת. מוצר שעוזר לצוות תמיכה יצטרך להעדיף עקביות וכיסוי של בסיס ידע. מוצר שמציג נתונים רגישים ייתן משקל גבוה במיוחד לבידוד בין חשבונות. כלי פנימי לצוות מצומצם עשוי לקבל יותר אי-ודאות, כל עוד יש דרך ברורה לבדוק את המקור. האסטרטגיה צריכה לשקף את הסיכון העסקי של כל טעות.
סדרו את שכבת הידע לפני שמשנים את ה-prompt
כאשר תשובות אינן מדויקות, הפיתוי הוא לשנות את ה-prompt שוב ושוב. Prompt הוא ההנחיה שנשלחת למודל יחד עם ההקשר שנשלף. הוא חשוב, אבל הוא השלב האחרון בשרשרת ארוכה. אם המסמכים משוכפלים, חסרים בהם מטא-דאטה, או שהם מפוצלים לקטעים לא הגיוניים, שינוי ניסוח בהנחיה לא יפתור את שורש הבעיה.
צריך לדעת מאיפה כל מסמך הגיע, מתי עודכן, לאיזה לקוח או סביבת עבודה הוא שייך, מי רשאי לראות אותו, ואיך אפשר להפנות אליו חזרה. במוצרים רבים, השדות האלה קיימים במערכת המקור אך נעלמים בזמן ההזנה למאגר הווקטורי. מאגר וקטורי מאפשר חיפוש לפי משמעות, אבל הוא אינו תחליף למודל נתונים תקין.
חלוקה נכונה של תוכן לקטעים חשובה לא פחות. קטע קצר מדי מאבד הקשר. קטע ארוך מדי מחזיר טקסט כללי ומגדיל עלויות וזמן תגובה. אין גודל קסם שמתאים לכל מסמך. חוזים, מדריכי מוצר, טבלאות וקריאות API דורשים כללי חלוקה שונים, ולכן כדאי לבדוק אותם על שאלות אמיתיות מהמערכת ולא על דוגמאות שנכתבו במיוחד להדגמה.
ציטוטים הם מנגנון בקרה, לא קישוט
ציטוטים מאפשרים למשתמש לבדוק תשובה, אבל גם לצוות לזהות במהירות איפה שרשרת המידע נשברה. אם ציטוט מוביל למסמך לא רלוונטי, ייתכן שהחיפוש נכשל. אם הוא מוביל למסמך הנכון אך הטענה אינה מופיעה בו, ייתכן שהמודל הרחיב מעבר למה שסופק לו.
כדאי לתכנן את הציטוט כחלק ממבנה התשובה ולא כתוספת ויזואלית בסוף. המערכת צריכה לשמור מזהי מקור ברמת הקטע, להעביר אותם לאורך התהליך, ולהציג רק מקורות שהמשתמש מורשה לראות. אחרת, הציטוט עצמו עלול לחשוף מידע רגיש.
הרשאות חייבות להיאכף לפני יצירת התשובה
במוצר רב-חשבונות, בידוד מידע אינו יכול להישען על הוראה למודל כמו אל תציג מידע של לקוחות אחרים. מודלים אינם מנגנון הרשאות. ההפרדה צריכה להתרחש בשכבת החיפוש ובשכבת ה-API, באמצעות סינון מחייב לפי חשבון, משתמש, תפקיד והקשר עסקי רלוונטי.
כאן מופיעה לעיתים פשרה אמיתית: פילטרים מורכבים יכולים לפגוע בביצועי החיפוש או להקשות על ארכיטקטורת הנתונים. ועדיין, אין מקום לקיצור דרך שבו מחפשים בכל מאגר המידע ואז מבקשים מהמודל לא לחשוף מה שאסור. אם ההקשר כבר נשלח למודל, הגבול כבר נפרץ.
כדאי גם לבדוק שינויים בהרשאות לאורך זמן. משתמש יכול לעבור תפקיד, מסמך יכול להפוך לפרטי, ולקוח יכול להסיר גישה לפרויקט. אסטרטגיה נכונה מגדירה כיצד שינויים כאלה מתעדכנים באינדקס, ולא מניחה שהרשאה שנקלטה פעם אחת נשארת נכונה לנצח.
evals הופכים שחרור שינויים להחלטה מבוקרת
בלי מדידה, כל שינוי ב-RAG הוא הימור. ייתכן ששיפור בחיפוש מעלה את איכות התשובות לשאלות נפוצות, אבל פוגע בשאלות מורכבות. ייתכן שמודל חדש מקצר את זמן התגובה, אך מפסיק לצטט מקורות בצורה עקבית. אי אפשר לזהות זאת רק מקריאת כמה שיחות ידניות.
evals הם סט בדיקות שיטתי למערכת AI. הוא כולל שאלות מייצגות, מקורות צפויים, תנאי הרשאה ותוצאה רצויה. חלק מהבדיקות יכולות להיות אוטומטיות, למשל האם התשובה כוללת ציטוט תקין והאם לא נשלף מידע מחשבון אחר. אחרות דורשות הערכה אנושית, במיוחד כאשר בודקים אם הניסוח באמת ענה על השאלה.
סט בדיקות טוב אינו חייב להתחיל במאות דוגמאות. אפשר להתחיל בשאלות שכבר גרמו לתקלות, בשאלות נפוצות של לקוחות, ובמקרי קצה של הרשאות. הדבר החשוב הוא להריץ אותו לפני ואחרי כל שינוי משמעותי בנתיב החיפוש, במודל, ב-prompt או בתהליך עיבוד המסמכים. כך הצוות יודע מה השתפר, מה נפגע ומה דורש החלטה מודעת.
תכננו עלות ומהירות כחלק מחוויית המוצר
תגובה איטית או יקרה מדי אינה בעיה שתיפתר רק אחרי שהפיצ'ר צובר שימוש. העלות מושפעת מכמות הטקסט שנשלחת למודל, מספר הקריאות, גודל התשובות, סוג המודל ומנגנוני retry. זמן התגובה מושפע מאותם גורמים, וגם מאיכות החיפוש ומהתלויות במערכות אחרות.
התשובה אינה תמיד לעבור למודל קטן יותר. לעיתים השיפור הנכון הוא לצמצם את מספר הקטעים שנשלחים, לדרג מחדש תוצאות חיפוש, לשמור תשובות חוזרות במטמון, או להפריד בין פעולה שדורשת תשובה מיידית לבין עיבוד שאפשר לבצע ברקע. כל בחירה משנה את איכות התשובה ואת מורכבות המערכת, ולכן צריך לבדוק אותה מול משימות אמיתיות ולא רק מול עלות לקריאה.
תרגמו את האסטרטגיה לתהליך פיתוח ברור
אסטרטגיית מוצר דיגיטלי שימושית רק אם היא מובילה לסדר עבודה. אנחנו בדרך כלל מתחילים במיפוי נתיב התשובה הקיים: מה נכנס מהמשתמש, איזה מידע נשלף, אילו פילטרים מופעלים, מה נשלח למודל, ואיך התוצאה נרשמת ונמדדת. המיפוי הזה חושף לעיתים בעיה פשוטה אך קריטית, כמו פילטר הרשאות שמופעל אחרי החיפוש או מסמך שמופיע באינדקס פעמיים בגרסאות שונות.
אחר כך כדאי לתעדף לפי סיכון. דליפת מידע בין חשבונות קודמת לשיפור סגנון התשובה. היעדר ציטוטים קודמת להוספת יכולת שיחה חדשה. ורק אחרי שיש בסיס אמין, נכון להרחיב את חוויית המוצר. זו לא גישה שמאטה פיתוח - היא מונעת מצב שבו כל יכולת חדשה מוסיפה עוד שכבת חוסר ודאות למערכת שכבר קשה לתחזק.
גם בעלות תפעולית צריכה להיות מוגדרת: מי בודק חריגות, מי מאשר שינוי במקורות המידע, מי מטפל בדיווח של משתמש, ואיזה נתונים נשמרים לצורך תחקור בלי לפגוע בפרטיות. מוצר אמין הוא לא רק קוד תקין. הוא תהליך פיתוח ברור שמאפשר לצוות להבין מה קרה ולפעול כשמשהו משתבש.
אם יש לכם פיצ'ר AI חי ואינכם יכולים להסביר בביטחון מאיזה מקור הגיעה כל תשובה, מי היה רשאי לראות אותה ואיך שינוי נבדק לפני שחרור, זה מקום טוב לעצור ולבדוק את הארכיטקטורה. אפשר לפנות דרך טופס יצירת הקשר באתר DevCo Solutions לשיחת סקירה קצרה וממוקדת של המערכת הקיימת.